 2026, Vol. 35


引用本文 |


2. 同济大学医学院,上海 200092
急诊医学是一个高风险、高压力、病情变化快的临床学科,要求医师具备在信息不全时做出正确判断的岗位胜任力[1]。目前,研究生临床思维培养面临着轮转带教时间少、接触急危重症机会不足等现实限制。而传统的基于案例的学习(case-based learning, CBL)由于缺乏高仿真实时互动,难以模拟复杂多变、不可预测的真实急诊情境[2]。
近年来,以ChatGPT为代表的大语言模型在医学教育中的应用已成为前沿热点,为复杂临床思维的培养提供了新契机。借助“生成式对话”模式,学生能够突破传统静态病历的限制,深层次地探究医学案例[3]; 特别是在面对“未分化疾病”时,LLM能为学生提供一个无风险的模拟试错环境,帮助其完成早期的临床思维训练[4]。此外,基于LLM的模拟患者系统可显著提高医学生的医患沟通技巧与临床情境逼真度[5],并通过提供“结构化反馈”有效提升其实践决策能力[6]。针对应急医学领域,运用包含“苏格拉底式导师”的高级提示词工程技术优化模拟教学,已成为拓展高阶临床思维训练场景的新方向[7]。
然而,尽管LLM具备显著的教学优势,将其直接应用于高阶医学教学仍存在“幻觉”误导和缺乏系统临床逻辑等固有风险[8-9]。为破解这一瓶颈,本研究基于知识图谱辅助教学理念[9],提出“知识图谱约束下的大语言模型教学”新模式。该模式以“情景对话+思维阶梯”为双核:一方面运用LLM产生高拟真急诊对话情景; 另一方面通过急诊医学知识图谱为LLM输出施加逻辑思维约束,引导学生进行循序渐进的推理。本研究旨在探索该模式在提升研究生高阶临床思维能力及优化教学资源配置中的有效性。
1 模式构建与教学实施 1.1 教学理念:从“知识灌输”转向“胜任力生成”依据建构主义和情境认知理论[10-11]——医师能力不是教出来的,是身处于时间紧、情况不明的高压“情境”中,在短时间内高效地利用各种资源解决问题而逐渐形成的。因此,本研究采用了AI技术打造高保真临床情境,让学生在“做中学”,让学生的隐性知识显性化。此外,本研究紧密结合国际公认的急诊医师胜任力框架(如ACGME六大核心能力及CanMEDS医师角色框架)[12-13],将胜任力导向的医学教育理念落地,明确界定了两大核心维度的培训目标:一是“沟通者”维度:急诊环境具有突发性、高压性和信息不明确性的特点。该维度的培训目标是使学生能在复杂的诊疗环境下,迅速与患者及其家属建立互信,掌握共情安抚、病史信息提取和清晰下达医嘱的技巧; 二是“专业人士”维度:培训目标是促使学生在面临未明确的急危重症时,不仅能熟练调用专科医学知识,更能够做出严谨的、具有排他性逻辑的临床推理(如高危胸痛的鉴别),并坚守医疗伦理与安全规范做出科学决策。研究采用AI技术打造高保真临床情境,让学生在“做中学”,有效促进了上述两大胜任力维度的达成与隐性知识的显性化。
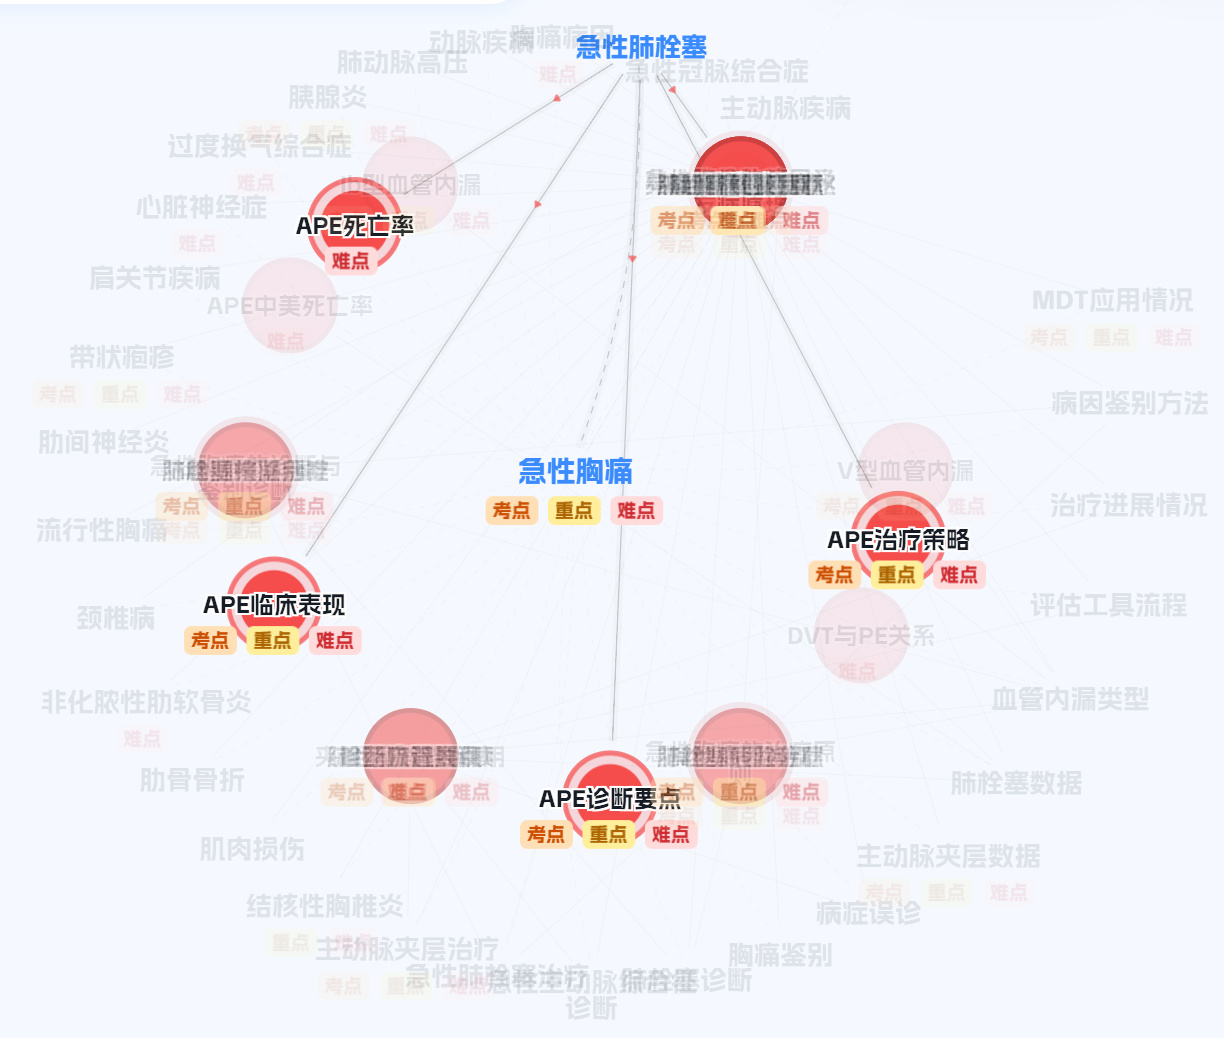
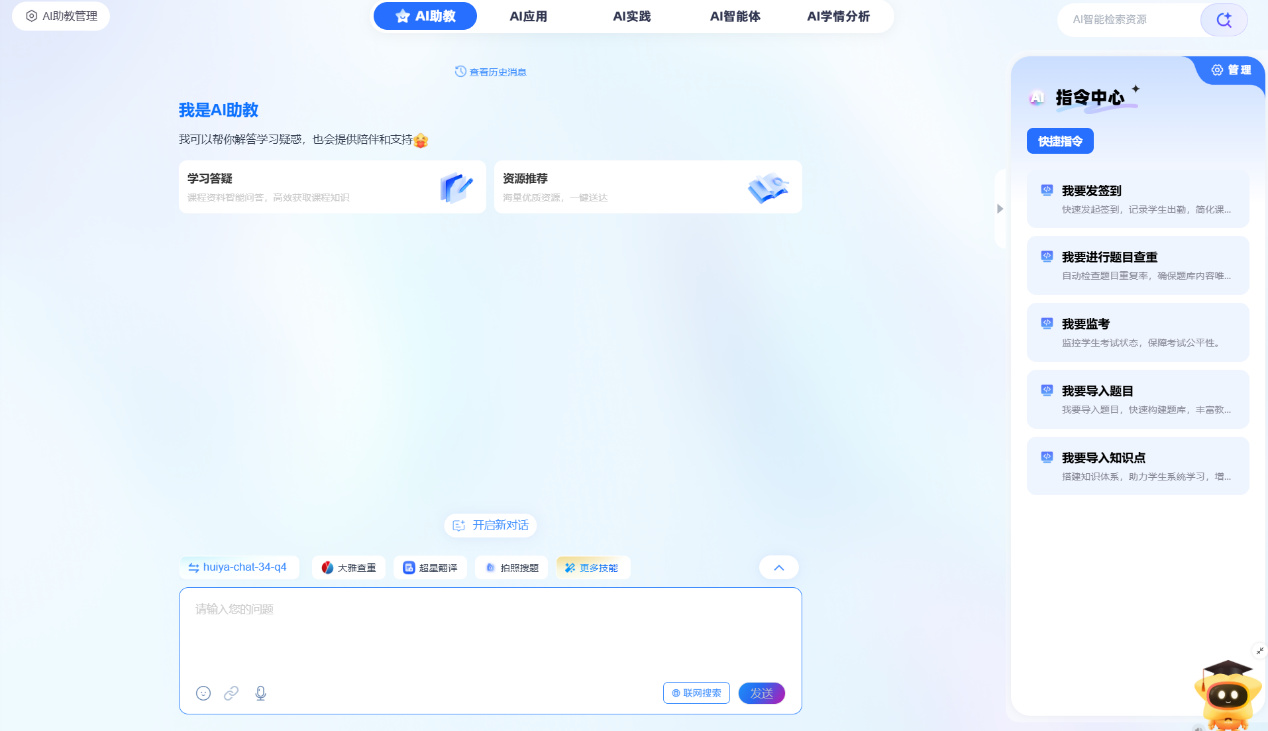
1.2 技术架构:“知识图谱+大语言模型”双引擎驱动本研究基于超星泛雅智慧课程平台算力,构建“知识图谱(逻辑层)+垂类大模型(交互层)”双核架构,结合医学逻辑做深度定制,将通用技术和急诊教学场景融为一体。在逻辑层构建了以教学为导向的知识图谱作为内核。从宏观上把学科体系划分为学科基础、急危重症诊疗、关键急救技术、学科前沿进展四大板块(含23个专题模块),完成了知识系统的梳理; 从微观上(图 1),以“急性胸痛”等临床问题为节点,向外发散相关知识点,并进行“考点、重点、难点”的标化设计,生成知识图谱,为AI生产内容提供逻辑约束和事实依据。在交互层构建“汇雅”急诊垂类大模型,以通用大模型“汇雅”为基础,输入清洗后的急诊临床指南、标准问答对、脱敏病例等私有语料,通过微调提升垂直领域知识的嵌入程度,保证回复的专业性、准确性,最后封装为“急诊AI助教”应用端(见图 2)。利用人工智能生成内容(artificial intelligence generated content, AIGC)技术,系统可实时动态地更新相应的课程内容,同时能够智能分析教学数据,并给予全天候的学习支持服务。
|
| 图 1 基于教学属性标注的急诊医学微观知识图谱(以急性胸痛鉴别诊断为例) |
|
|
|
| 图 2 AI助教运行界面之一 |
|
|
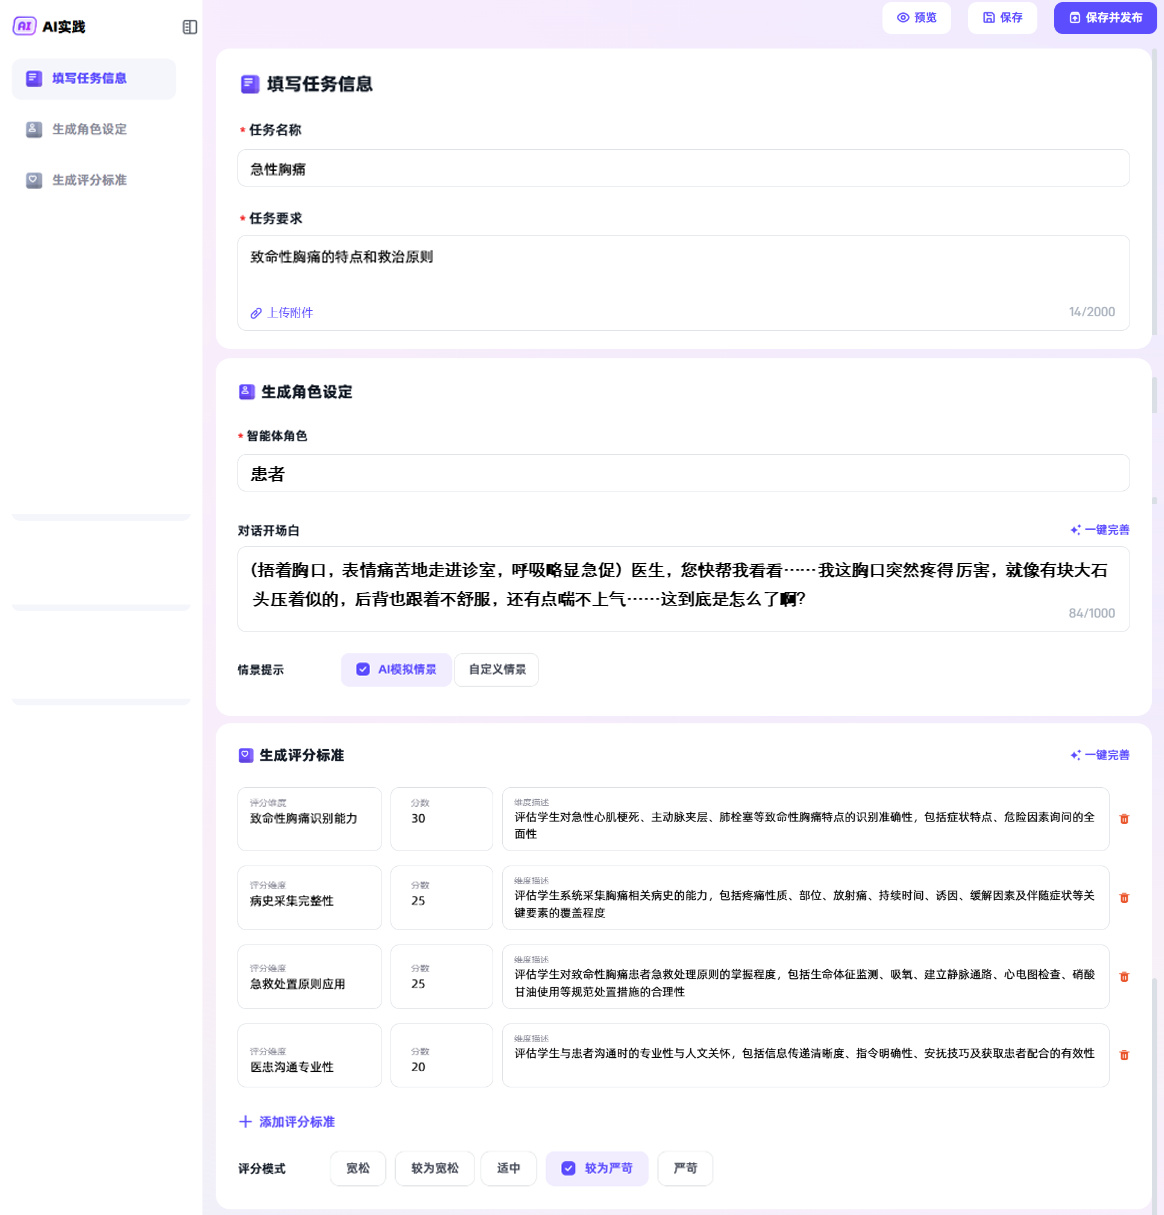
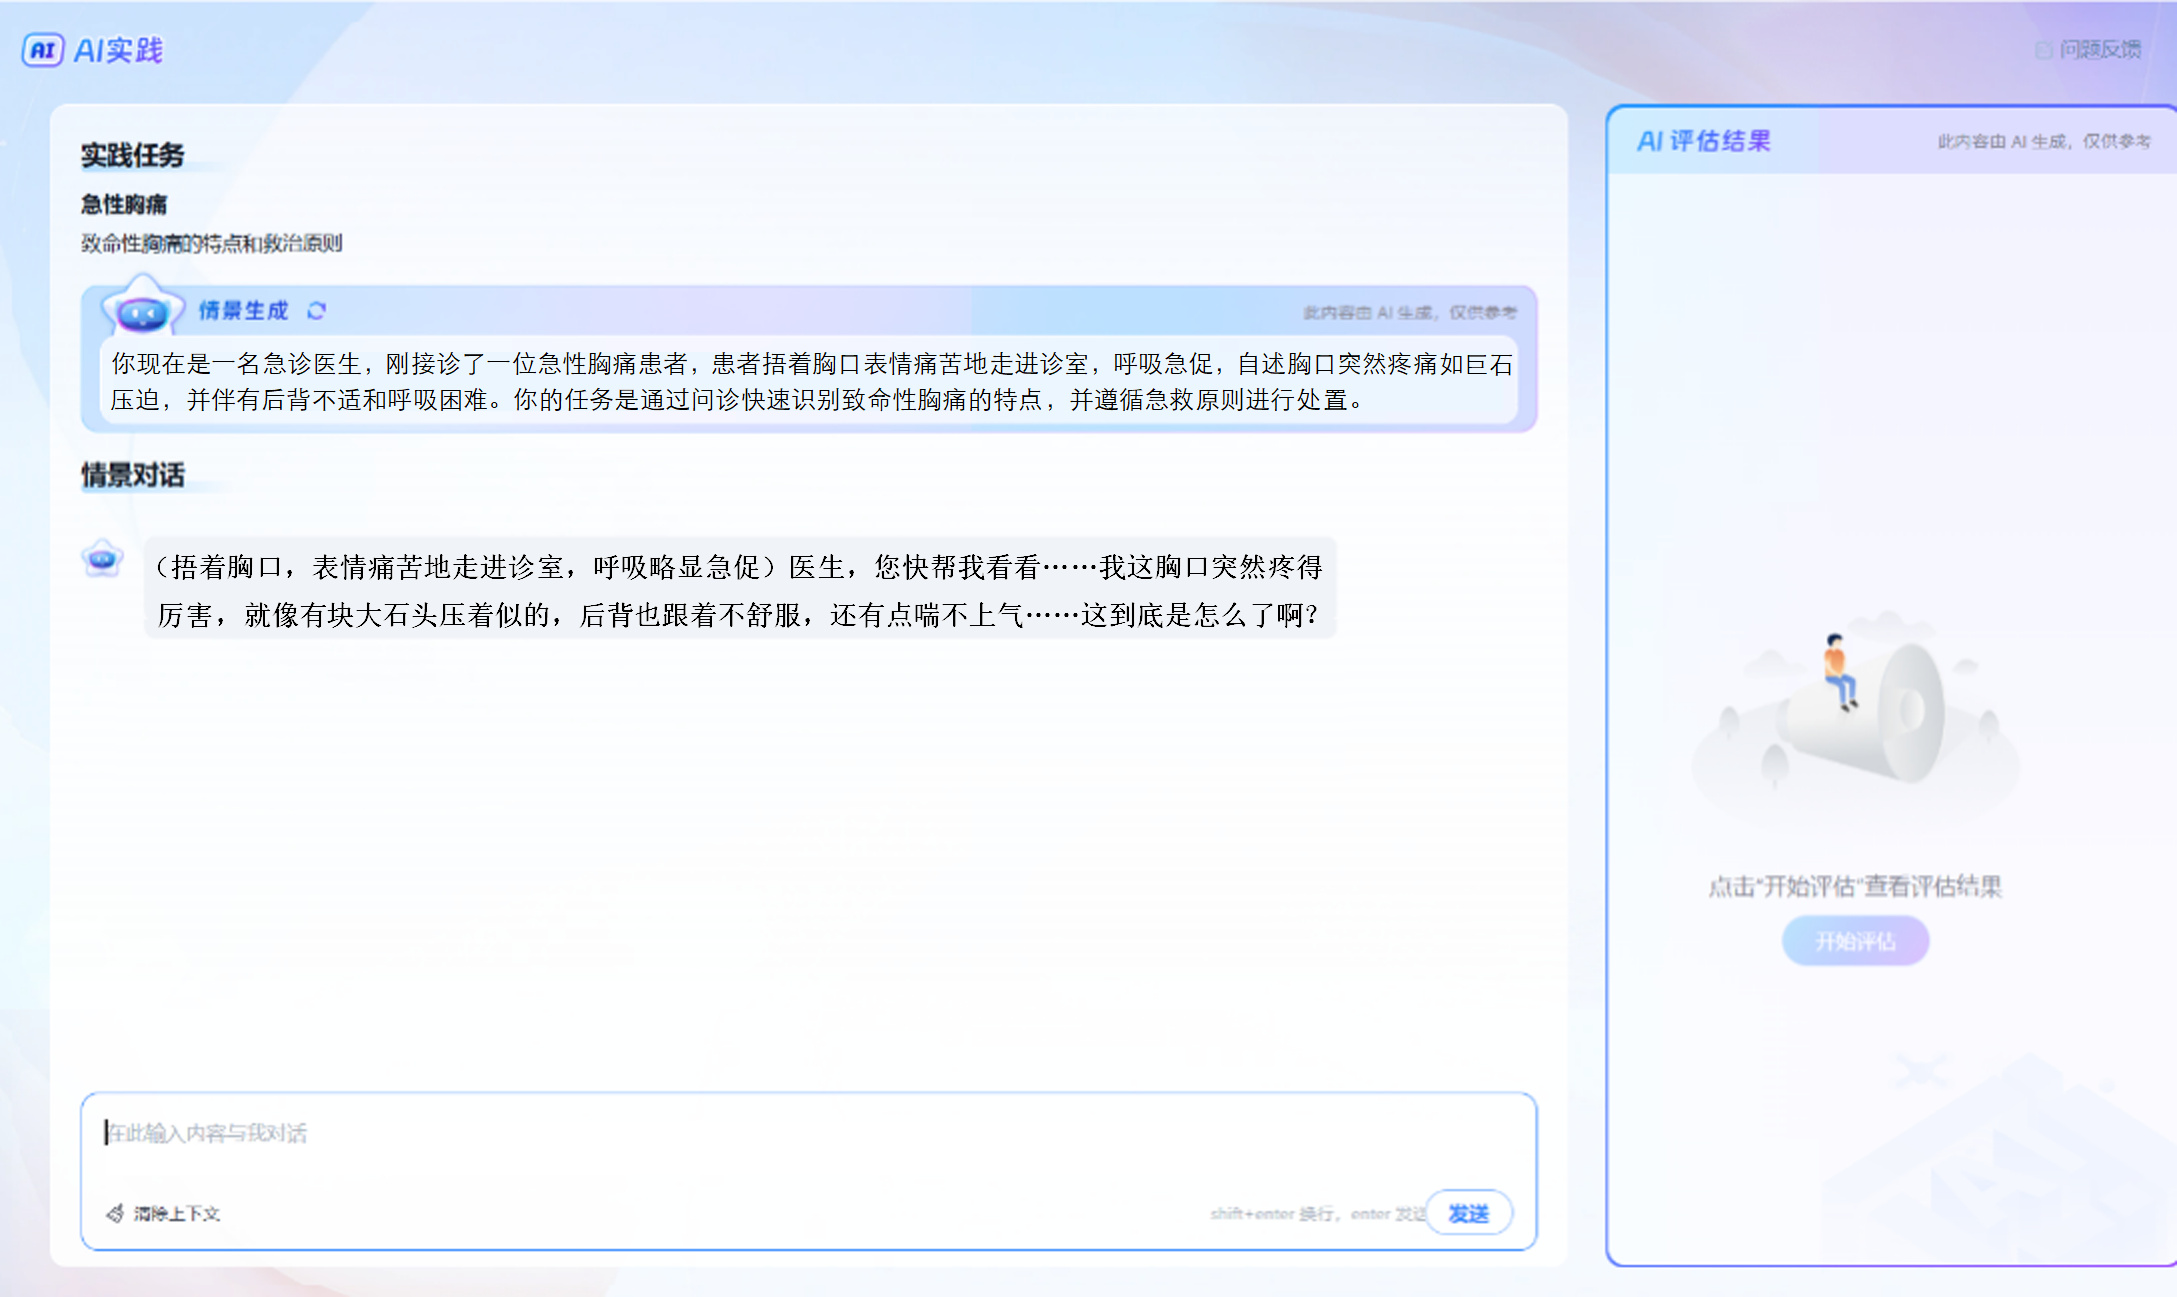
基于此双核架构,本项目设立了两个教学核心模块,分别围绕“沟通者”和“专业人士”展开。“沟通者”教学模块由生成式情景对话、智能评价模块构成,在此模块设计中结合了浸入式问诊训练来提高临床沟通与处置能力。并且采用了提示词工程(prompt engineering)将模板设计成病例,设置详细的参数项,例如选择“急性胸痛”做模板时,设定背景信息是“患者捂着胸口,呼吸困难”的“智能体”。笔者自行设计多维生成式评分矩阵(如图 3所示),其中包含了“致死性胸痛识别(30分)、病史采集(25分)、急救处置(25分)和沟通专业性(20分)”作为考核项,并最终将主观的问诊转变成可量化的具体分数。在实训部分,学生依照AI患者的提问(“像是有块大石头压着一样”)进行自主思考、反复探究问诊,并且在学生询问的过程中不断调整故事情节,例如探查是否放射痛、诊治经过等; 最后当实训结束时根据学生答题得分情况进行智能式训练评价反馈(如图 4所示),形成“练—测—评”智能教学闭环。“专业人士”教学模块主要是构建思维阶梯,进行任务路径驱动的结构化推理。采用思维链技术将复杂多样的临床决策过程拆分为基于知识图谱的思维节点。以“重症血液净化技术”为例,在教学设计过程中将教学目标直接转化为“技术分类→治疗模式抉择→滤器选型→抗凝方案制定→血管通路建立”这一任务链条的教学目标,并以此为基础来进行设计。这种“思维阶梯”的设计深度契合临床推理的“双过程理论”[14]。急诊研究生作为初学者,在面对未明确急诊病患时,往往难以直接产生专家的“系统1”(快速、依赖模式识别的直觉性思维)。因此,“思维阶梯”本质上是为学生搭建了一个认知支架,强制其调用“系统2”(缓慢、有意识的分析性思维),即沿着知识图谱的逻辑节点进行降解与逐层推理。借助AI提供的高保真、高频次的“练—测—评”闭环实训,学生在安全的模拟环境中不断重复规范化的系统2分析过程。这种反复的“刻意练习”有助于加速学生积累并丰富自身的“疾病剧本”,促使其临床决策逐渐摆脱对繁琐认知支架的依赖,最终实现从按部就班的“分析性思维”向高效、敏锐的“直觉性思维”的平滑过渡。
|
| 图 3 AI情景模拟教学模块构建与实施教师端:角色设定与多维评分标准配置 |
|
|
|
| 图 4 AI情景模拟教学模块构建与实施学生端:急性胸痛患者模拟问诊交互 |
|
|
本研究依托同济大学网络教学平台(https://e-learning.tongji.edu.cn/),设计完成以“自主探究—课前准备—课堂互动—课后巩固—课外拓展”的五步闭环学习任务链:通过超星泛雅智慧教学平台(移动端“学习通”APP + PC端)课前发放任务单给学生,让学生登录平台进入“急诊医学知识图谱”; 图谱以可视化形式展示出该章节重要知识点和逻辑关系,学生可通过点击图谱节点,找到相应微课视频链接或最新指南等相关文献; 课中利用AI“情景对话”功能开展分组竞赛。每组学生需在规定时间内对同一位AI模拟的患者进行问诊。系统后台会实时给出“疾病识别能力”“问诊效率”等多项评分。实训结束后,平台生成学生个人“临床思维能力画像”,面向每位学生展示他们的“信息提取”、“逻辑推理”、“同理心”等方面得分和不足,同时推送相关复习资源,完善学生个性化辅导; 也可以通过知识图谱“扩展层”,给学有余力的同学推送干细胞治疗、AI辅助诊断等方面的最新文献资料,引导同学进行探究式学习。
1.5 评估指标与统计学方法本研究采用客观系统日志与主观问卷调查相结合的方式进行评估。客观数据包括平台访问量、AI实训任务完成数及知识点得分率,连续变量以均数和标准差(x±s)表示,其中方差专门用于衡量班级学生参与度的离散程度。主观数据通过课程结束后发放自编的《基于LLM的急诊教学效果与满意度问卷》进行收集。该问卷设计主要包含总体评价、内容前沿性、工具有效性及系统易用性等维度,题目示例包括:“您对该‘情景对话+思维阶梯’模式的总体评价是?”、“您认为AI情景实训是否有助于提高您的临床决策信心?”等。问卷采用李克特5级计分法(Likert 5-point scale:5分=非常满意/非常认同,1分=非常不满意/极不认同)。所有数据使用SPSS 26.0软件进行统计分析。计数资料以频数和百分比(%)表示; 总体满意度/认同度计算口径为:(“非常满意”人数+“满意”人数)/ 总人数× 100%。
2 教学效果与成效评估为了更加客观地评价教学模式的效果,选择同济大学医学院2025级选修《急诊医学进展》课程的29名学生作为研究对象,采用全过程学习数据(平台行为日志数据和AI实训成绩)以及期末的匿名问卷作为评价指标,从学习行为、能力达成、主观评价等角度进行量化评价分析。
2.1 学习行为分析:高频互动与深度参与根据超星泛雅平台一学期的后台数据可知(见表 1),在线学习具有明显的持续性高频互动的特点:研究对象累计平台访问量超过2 700次(生均93次)高于学校平台以往开设的一般线上课程的访问量; 平台发起在线讨论活动次数为96次,生均超3次。说明学生通过平台开展主动学习、积极思考而非被动接受的内容占比较大。更为关键的是实训参与的均衡性表现。本学期共设置17项AI实训任务(包括情景对话实训、思维阶梯实训),学生平均完成任务16.55次(平均完成率达97.4%)。特别值得注意的是,该任务完成数的统计学方差(S2)仅为0.80。这一极小的数值代表了29名学生在任务完成量上的离散程度极低,意味着全班同学的实训参与度高度集中。这从数据层面客观说明了全体学生对于AI新教学模式的接受度非常一致,未出现部分学生积极而另一部分学生弃用的“两极分化”现象,有效地验证了该教学干预在班级内的普适性。
| 指标维度 | 统计数据 | 教学含义 |
| 平台累计访问量 | 2700+次 | 高粘性与持续性 |
| 知识点平均完成率 | 98% | 基础知识覆盖全面 |
| AI任务平均完成数 | 16.55 /17 | 参与度高 |
| 作业平均完成率 | 99.43% | 执行度高 |
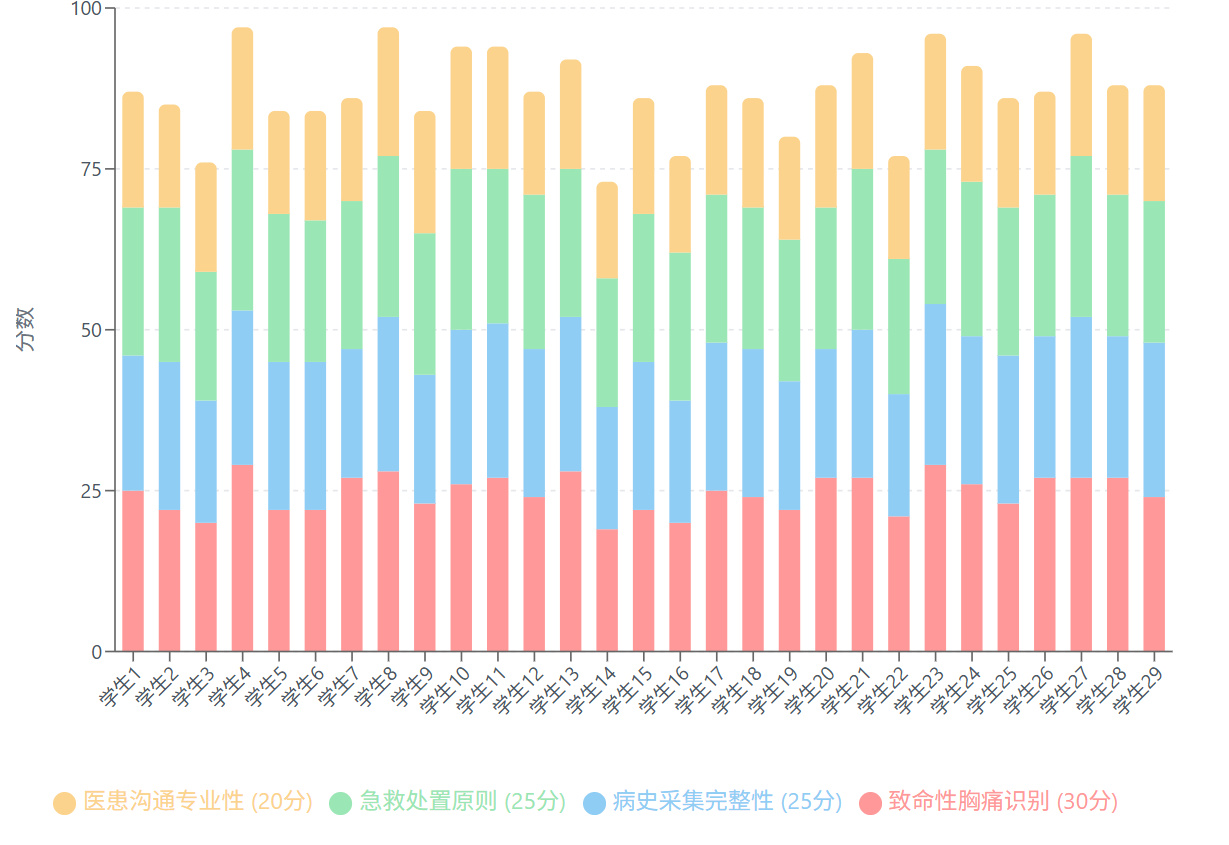
本课程打破了过去单纯以总分为判断标准的模式,利用AI系统后台对学生临床胜任力进行了多维度的量化评价。以期末AI情景实训“急性胸痛”模块为例(考核总分100分,各亚维度得分如图 5所示),客观评测数据如下:在体现高阶临床逻辑的“致命性胸痛识别能力”维度(满分30分)中,班级平均得分为27.0分,平均答题正确率(得分率)达到90.0%。这组客观实测数据表明,通过“知识图谱”导引与“思维阶梯”循序渐进的干预,研究生能够准确建立排除高危病因(如主动脉夹层、肺栓塞)的严密逻辑; 在“病史采集完整性”(满分25分)与“急救处置原则”(满分25分)维度中,班级平均得分率分别达到85.2%(21.3分)和88.0%(22.0分),进一步用具体量化指标证明了该训练方式对学生临床思维与决策能力的实质性强化作用。然而,“人文”维度的数据呈现出显著波动。在“医患沟通专业性”维度(满分20分)中,班级平均得分率仅为72.5%(14.5分),有近三分之一学生的该项得分率徘徊在60%~80%之间。这不仅客观暴露了急诊研究生“重技轻文”的现状,同时也从数据层面验证了AI作为“虚拟标准化病人(standardized patients,SP)”在捕捉沟通细节(如是否安抚情绪、指令是否清晰)方面的高敏感度。
|
| 图 5 急性胸痛章节的AI实践情景对话各维度得分柱状图 |
|
|
匿名问卷调查(n=29, 回收率100%)结果显示,大部分同学对该课程形式比较满意。在总体评价上,有93.1%的同学给予“非常满意”和“满意”的高分; 绝大部分同学都对该课程所涉及到的课程内容的深度与广度以及前沿性十分满意。针对AI工具的有效性,也有89.6%的同学认为AI工具确实能够帮助提升临床思维。同时还有同学认为:“AI就是一本百科全书,想问啥就给你啥”、“情景对话是真实的临床沟通场景,在一定程度上弥补了轮转的机会不足”。然而问题也存在:约10%的学生认为“AI太死板”或者“移动端不太方便”,这说明还应不断丰富提示词,并改进移动端界面,减少使用中的认知负荷。
3 讨论本研究结果显示,通过“情景对话+思维阶梯”模式干预,学生在“致命性胸痛识别”等高难度核心维度上达到了极高的准确率(90.0%)。这表明,与以往经过“消毒”的静态文本病历不同[2],AI生成的高保真“濒死感”或情绪焦虑状态,成功激活了真实急诊高压情境下的认知挑战。在此情境下,建构主义强调的“思维阶梯”支架发挥了关键作用[10]。对于尚未形成成熟“疾病剧本”的急诊初学者,这种结构化的AI引导强制其调用缓慢、严密的“分析性思维”(系统2),在不全信息中层层抓取关键线索。通过高频次的无风险试错,学生逐渐将外在的分析步骤内化,从而有效促进了其临床决策向高效的“直觉性思维”(系统1)过渡[15]。然而需要客观指出,该模式存在一定的适用边界:其在发病迅速、逻辑推理性强的急症(如胸痛、中毒等)中效果显著,但无法替代腹部触诊、气管插管等需要丰富视触叩听感觉反馈的实体性临床技能训练。
尽管生成式AI潜力巨大,但Thirunavukarasu等[16]曾警示其不确定性可能误导初学者。为应对通用大模型依靠概率生成而产生的“一本正经的胡说八道”风险[8, 17],本研究采用了“知识图谱”作为事实锚点,并在模型微调过程中引入了检索增强生成(retrieval-augmented generation, RAG)技术,使AI生成的答复仅来源于已审核的急诊专科知识库。系统后台数据显示,该私有模型在回答诸如“体外膜肺氧合(extracorporeal membrane oxygenation, ECMO)上机指征”等高度专业化问题时,其准确性与逻辑严密性均显著优于通用大模型,从技术底层保障了医学教育的严谨性与安全性。
值得注意的是,问卷数据中约有10%的学生反馈“AI回答生硬”或交互体验不佳。深入分析发现,这并非模型算力问题,而是折射出部分初学者在“提示词工程(Prompt engineering)”能力上的短板[9]。传统的搜索引擎使用习惯使学生难以迅速适应与AI的多轮逻辑交互。因此,智能化教学改革的落脚点不仅在于技术平台的搭建,更在于师生数字素养的培育。在后续教学中,我们将《急诊AI助教交互提示词指南》纳入常规教学内容,引导学生学会如何精准“问诊”AI。
正如梁梦琳等[1]指出,智能化工具的应用能力已成为新时代急诊医师的核心素养。未来的医学教育不再是单纯的“人教人”,而是“人+AI”共同进化的新范式。将AI作为全天候“陪练员”,让学生在规培阶段就熟练掌握调用AI知识库辅助决策的技能,是培养新型急诊人才的必由之路。未来,我们有望将此类已验证的垂类大模型直接嵌入急诊医生工作站,实现从教学场景向真实临床场景的无缝转化。
本研究作为一项探索性实践,尚存在一定局限性:受限于选修课程的实际规模,样本量偏小(n=29),且出于教学公平性考量采用了单组观察设计,缺乏严谨的平行对照,这在一定程度上限制了对该模式绝对教学效能的量化评估。未来我们研究团队将依托多中心平台,引入随机对照试验及将客观结构化临床考试(objective structured clinical examination, OSCE)作为硬性终点评价指标。
利益冲突 所有作者声明无利益冲突
| [1] | 梁梦琳, 李晨, 何新华. 浅析人工智能时代急诊医师胜任力[J]. 中华急诊医学杂志, 2025, 34(12): 1802-1806. DOI:10.3760/cma.j.cn114656-20241217-00880 |
| [2] | MacLeod A, Luong V, Cameron P, et al. Case-informed learning in medical education: a call for ontological fidelity[J]. Perspect Med Educ, 2023, 12(1): 120-128. DOI:10.5334/pme.47 |
| [3] | 刘红蕾, 王宇, 朱丛敏, 等. 在医学人工智能本科生课程中使用大语言模型辅助案例思考的教学实践研究:“生成式对话+案例思辨”的教学模式探索[J]. 中国信息技术教育, 2025(21): 110-112. DOI:10.3969/j.issn.1674-2117.2025.21.034 |
| [4] | 胡梦杰, 任文, 任菁菁. 大语言模型在未分化疾病教学中的应用探讨及案例分析[J]. 中国毕业后医学教育, 2025, 9(4): 277-282. DOI:10.3969/j.issn.2096-4293.2025.04.009 |
| [5] | Elhilali A, Ngo AS, Reichenpfader D, et al. Large language model-based patient simulation to foster communication skills in health care professionals: user-centered development and usability study[J]. JMIR Med Educ, 2025, 11: e81271. DOI:10.2196/81271 |
| [6] | Brügge E, Ricchizzi S, Arenbeck M, et al. Large language models improve clinical decision making of medical students through patient simulation and structured feedback: a randomized controlled trial[J]. BMC Med Educ, 2024, 24(1): 1391. DOI:10.1186/s12909-024-06399-7 |
| [7] | Meynhardt C, Meybohm P, Kranke P, et al. Advanced prompt engineering in emergency medicine and anesthesia: enhancing simulation-based e-learning[J]. Electronics, 2025, 14(5): 1028. DOI:10.3390/electronics14051028 |
| [8] | 颜士刚, 胡修磊, 李文光. 生成式大语言模型能有效实现对话式教学吗[J]. 现代远程教育研究, 2025, 37(2) 52-61, 72. DOI:10.3969/j.issn.1009-5195.2025.02.006 |
| [9] | 王佐旭. 知识图谱和大语言模型辅助新工科课程教学资源建设方法[J]. 高等工程教育研究, 2025(1) 40-46, 110. |
| [10] | Kaufman DM. Applying educational theory in practice[J]. BMJ, 2003, 326(7382): 213-216. DOI:10.1136/bmj.326.7382.213 |
| [11] | Greeno JG. The situativity of knowing, learning, and research[J]. Am Psychol, 1998, 53(1): 5-26. DOI:10.1037/0003-066x.53.1.5 |
| [12] | Pritchard J, Alavian S, Soogoor A, et al. Global health competencies in postgraduate medical education: a scoping review and mapping to the CanMEDS physician competency framework[J]. Can Med Educ J, 2023, 14(1): 70-79. DOI:10.36834/cmej.75275 |
| [13] | Chang MW, Kung CT, Yu SF, et al. Exploring the Critical Driving Forces and Strategy Adoption Paths of Professional Competency Development for Various Emergency Physicians Based on the Hybrid MCDM Approach[J]. Healthcare (Basel), 2023, 11(4): 471. DOI:10.3390/healthcare11040471 |
| [14] | Norman G, Pelaccia T, Wyer P, et al. Dual process models of clinical reasoning: The central role of knowledge in diagnostic expertise[J]. J Eval Clin Pract, 2024, 30(5): 788-796. DOI:10.1111/jep.13998 |
| [15] | Rao AS, Esmail KP, Lee RS, et al. Large Language Model Performance and Clinical Reasoning Tasks[J]. JAMA Network Open, 2026, 9(4): e264003. DOI:10.1001/jamanetworkopen.2026.4003 |
| [16] | Thirunavukarasu AJ, Ting DSJ, Elangovan K, et al. Large language models in medicine[J]. Nat Med, 2023, 29(8): 1930-1940. DOI:10.1038/s41591-023-02448-8 |
| [17] | Gong EJ, Bang CS, Lee JJ, et al. Knowledge-Practice Performance Gap in Clinical Large Language Models: Systematic Review of 39 Benchmarks[J]. J Med Internet Res, 2025, 27: e84120. DOI:10.2196/84120 |